Pengadilan Agama Pulang Pisau Raih Nilai 100 Pengelolaan Website
Pada Triwulan III Tahun 2026
import pypdf
reader = pypdf.PdfReader("30. E-Learning Petty Corruption Integrity Rangers_compressed.pdf")
print("Total pages:", len(reader.pages))
for i, page in enumerate(reader.pages):
print(f"--- PAGE {i+1} ---")
print(page.extract_text())
Output kode
Total pages: 2
--- PAGE 1 ---
Kartini Kartini
E-Learning Petty Corruption Integrity Rangers
3968/150/09/2026
23 September 2026
Aksi Bersama Lawan Korupsi
Jakarta,
--- PAGE 2 ---
Powered by TCPDF (www.tcpdf.org)
Python
import fitz # wait, pymupdf was not installed, let's use pdfplumber or fitz check or extract raw objects
# let's try reading images or raw streams from pypdf
page = reader.pages[1] # page 2
print("Page 2 raw text:", page.extract_text())
print("Page 1 raw text:", reader.pages[0].extract_text())
# Let's inspect objects on page 2 using pypdf
for i, page in enumerate(reader.pages):
print(f"Page {i+1} contents:")
print(page.get_contents())
Output kode
Traceback (most recent call last):
File "", line 1, in
import fitz # wait, pymupdf was not installed, let's use pdfplumber or fitz check or extract raw objects
ModuleNotFoundError: No module named 'fitz'
Python
# Let's inspect text again or extract images/text with pypdf
for i, page in enumerate(reader.pages):
print(f"=== Page {i+1} ===")
print(page.extract_text(orientations=(0, 90, 180, 270)))
Output kode
=== Page 1 ===
Kartini Kartini
E-Learning Petty Corruption Integrity Rangers
3968/150/09/2026
23 September 2026
Aksi Bersama Lawan Korupsi
Jakarta,
=== Page 2 ===
Powered by TCPDF (www.tcpdf.org)
Python
# Let's inspect images on page 1 and page 2 or check if there is OCR needed
import pypdf
reader = pypdf.PdfReader("30. E-Learning Petty Corruption Integrity Rangers_compressed.pdf")
for page_num, page in enumerate(reader.pages):
print(f"Page {page_num+1} images count:", len(page.images))
for img_idx, img in enumerate(page.images):
print(f"Image {img_idx}: {img.name}")
Output kode
Page 1 images count: 2
Image 0: X0.jpg
Image 1: X1.png
Page 2 images count: 2
Image 0: X2.jpg
Image 1: X3.png
Python
# Let's perform OCR using pytesseract or inspect full details of page text
try:
import pytesseract
from PIL import Image
import io
for page_num, page in enumerate(reader.pages):
for img_idx, img in enumerate(page.images):
image = Image.open(io.BytesIO(img.data))
text = pytesseract.image_to_string(image)
print(f"--- Page {page_num+1} Image {img_idx} OCR ---")
print(text)
except Exception as e:
print("Error:", e)
Output kode
Error: No module named 'pytesseract'
Pulang Pisau | pa-pulangpisau.go.id
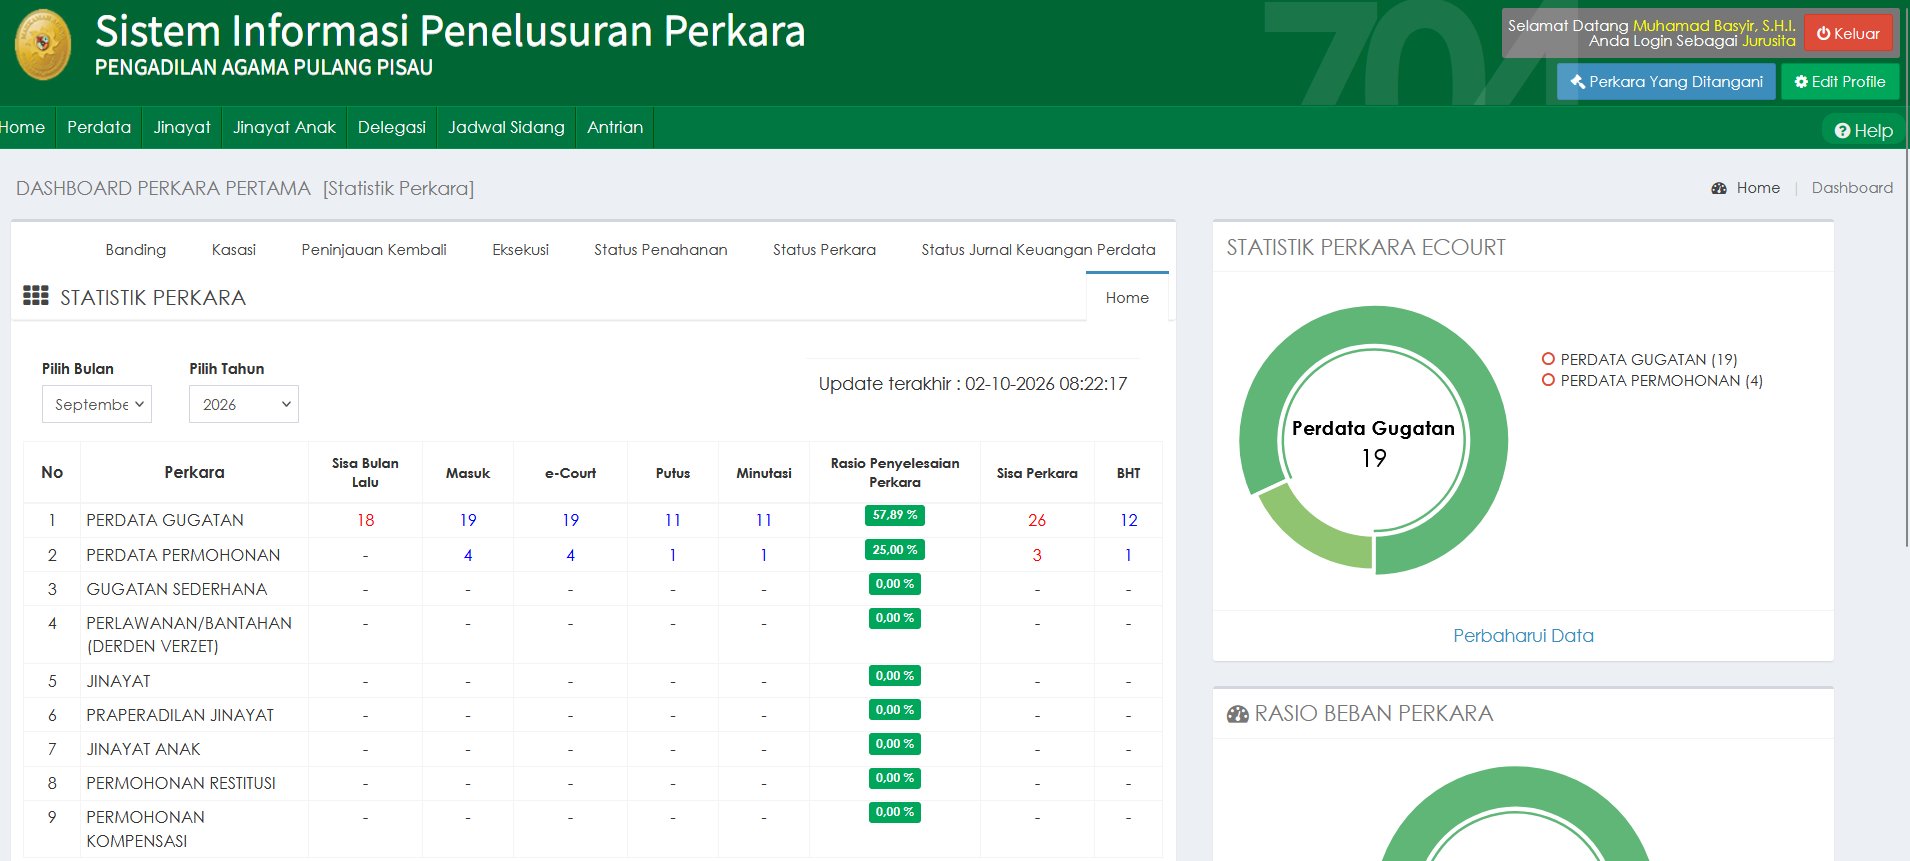
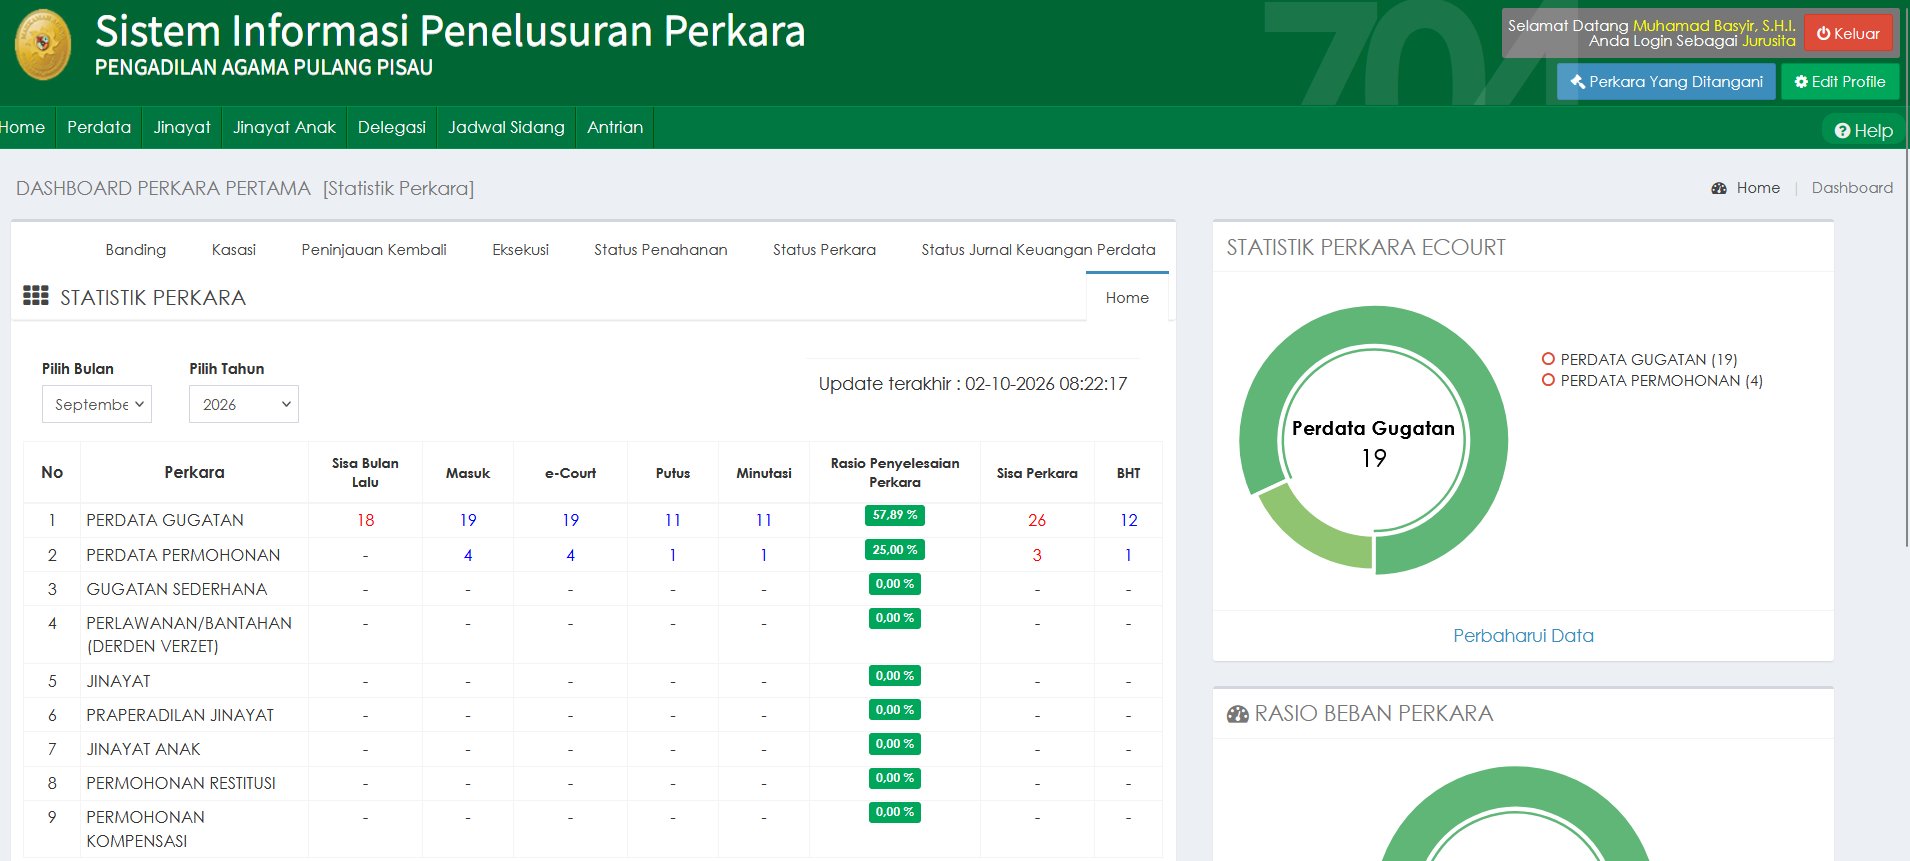
Kamis, 1 Oktober 2026 - Pengadilan Agama Pulang Pisau berhasil meraih predikat sempurna dengan Nilai 100 pada penilaian Kategori Pengelolaan Website Terbaik Triwulan III Tahun 2026. Penghargaan ini ditetapkan langsung oleh Ketua Pengadilan Tinggi Agama Palangka Raya atas standar kualitas portal resmi Pengadilan Agama Pulang Pisau. Penilaian ini melingkupi kelengkapan informasi publik, pembaruan konten berita, aksesibilitas layanan, serta kepatuhan terhadap standar keterbukaan informasi.
Raihan nilai sempurna ini menunjukkan bahwa website Pengadilan Agama Pulang Pisau mampu menyajikan informasi yang transparan, komunikatif, dan user-friendly bagi masyarakat. Seluruh menu informasi seperti jadwal sidang, transparansi keuangan, profil lembaga, dan inovasi layanan publik tersaji secara runtut dan selalu diperbarui. Keberhasilan ini menjadi sarana ampuh dalam mewujudkan peradilan yang terbuka dan responsif terhadap kebutuhan masyarakat.
Pimpinan Pengadilan Agama Pulang Pisau menyampaikan terima kasih kepada Tim Pengelola Website dan Teknologi Informasi yang terus berinovasi. Pengelolaan portal berita dan informasi yang transparan merupakan wujud nyata pelaksanaan keterbukaan informasi publik di lingkungan badan peradilan. Pengadilan Agama Pulang Pisau berkomitmen untuk terus merawat dan mengembangkan kualitas situs web agar selalu menjadi rujukan informasi yang terpercaya.
C.A.T. (Cepat, Aktual, dan Terpercaya), Yewtree/Timred”